
ИИ-сервисы могут быть помощниками в деле проверки фактов. Но чтобы их протестировать, нужны материалы. На основе материалов проекта «Проверено.Медиа» и запросов пользователей мы собрали уникальный датасет для того, чтобы узнать, насколько успешно разные модели ИИ проверяют факты. Этот набор данных мы используем сами — для калибровки сервиса Factbutcher, с которым вы можете проверять информацию. Кстати, он теперь бесплатный.
Сейчас мы готовим полный набор из 423 утверждений к открытой публикации на GitHub и Hugging Face. Еще мы поделимся с вами кодом, с которым можно будет подставить свой API-ключ, модель и промпт и попробовать улучшить результат. Следите за обновлениями.
Кратко. Что такое Factbutcher?
Factbutcher — сервис проверки утверждений с помощью ИИ. Пользователь вводит фразу, сервис ищет информацию в интернете, выносит один вердикт: «правда», «ложь» или «не определено». В ответе будут также источники, на которых ИИ сделал вывод.
Проверка состоит из двух основных этапов:
1) пользователь вводит текст — сервис выделяет из него проверяемые утверждения;
2) для каждого утверждения FactButcher ищет информацию и дает один из четырех ответов: «правда», «ложь», «неопределено» или «недостаточно данных», все — со ссылками на источники.
В этом исследовании мы тестировали только второй этап — проверку уже выделенных, проверяемых утверждений.
Что мы узнали из исследования? Краткий пересказ
- Правильного вердикта недостаточно. Например, у Gemini Flash ответы правильные, но источники и ссылки выдуманные.
- ИИ редко ошибается, но часто осторожничает. Менять местами «Правду» и «Ложь» почти никто не стал, зато «неопределенных ответов» довольно много.
- Ни один из ИИ не подойдет на 100%. Один вариант лучше связывал источники и выводы, другой реже ошибался, и т.п.
Что стоит знать про фактчекинг с помощью ИИ?
- ИИ — не полноценная замена фактчекера. Его можно (и нужно) использовать как дополнительный инструмент проверки фактов, как что-то упрощающее работу с утверждениями или цитатами.
- ИИ может галлюцинировать. Редко, но машина может опираться на устаревшую информацию, неверно понимать контекст и приводить источники, которые или не подтверждают написанное, или вообще не существуют.
- Дорогие модели не гарантируют качественный фактчекинг.
- Ни одна из моделей не может самостоятельно определить, где правда, а где — нет. Это краткое исследование, как конкретные модели справились с проверкой нашего набора русскоязычных утверждений (423 утверждения, в июле 2026 года).
- При этом возможности ИИ быстро растут. При правильном устройстве продукта он может взять на себя поиск, первичный разбор и оформление доказательств — то есть сделать фактчекинг доступнее людям, у которых нет времени или профессиональной подготовки для полноценного расследования.
Что и как мы исследовали?
Для оценки мы собрали FactButcher Eval Dataset: 423 утверждения из двух независимых компонентов. На базе этого датасета мы сравнили модели OpenAI, Google, Anthropic и Perplexity. Стоимость и время ответа мы записывали отдельно. Сами по себе они ничего не говорят о качестве проверки.
Что входит в датасет?
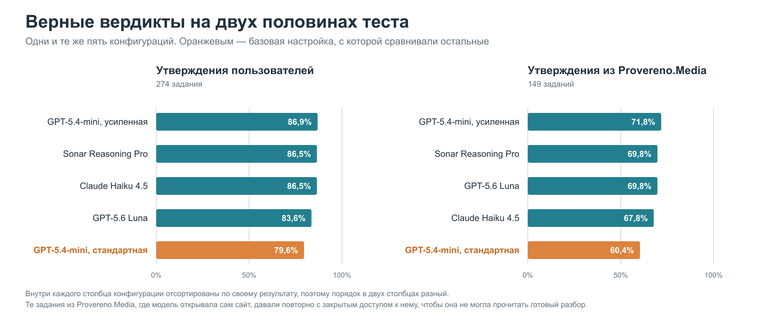
- 149 утверждений по материалам «Проверено.Медиа» (Provereno.Media). «Проверено.Медиа» — ведущий фактчекинговый портал на русском языке, который распространяет свои данные под свободной лицензией. Материалы «Проверено» взяли как своеобразный эталон проверки фактов. Заодно у ИИ появился доступ к профессиональному обоснованию вердиктов.
- 274 пользовательских утверждения. То, что люди присылают нам: фрагменты новостей, бытовые вопросы, слухи, цитаты, при этом запросы далеко не всегда четко сформулированы. Здесь эталонные вердикты были получены через многоступенчатую процедуру с одновременным применением нескольких сильных моделей и проверкой человека. Главное преимущество здесь в том, что это то, что люди реально спрашивали у нашего чатбота.
| Что проверяли | Что это означало |
|---|---|
| Вердикт | Попал ли ответ модели в заранее определённый набор допустимых вердиктов? |
| Источники и логика | Открываются ли ссылки, подтверждают ли они ключевые факты и действительно ли из этих фактов следует вывод модели? |
| Сравнение с «Проверено.Медиа» | Совпадает ли логика модели с опубликованным профессиональным разбором или модель нашла другой, но всё равно обоснованный путь? |
Что мы брали у «Проверено.Медиа»
«Проверено.Медиа» — проект, который занимается проверкой информации и разоблачением фейков. В своей работе эксперты «Проверено» используют более подробную шкалу, чем мы. Чтобы упростить проверку, перед тестом мы разделили редакционные формулировки на три класса.
| Примеры вердиктов «Проверено.Медиа» | Вердикт бенчмарка |
|---|---|
| «Правда», «Большей частью правда», «Скорее всего, правда», «Верная цитата» | Правда |
| «Неправда», «Большей частью неправда», «Фейк», «Заблуждение», «Неверная атрибуция цитаты» | Ложь |
| «Полуправда», «Вырвано из контекста», «Искажённая цитата», «Это не точно», «Легенда» | Неопределено |
Следом мы читали аргументацию исходной статьи «Проверено.Медиа» и проверяли, соответствует ли ей выбранный вердикт. В случаях, где профессиональный разбор допускал соседнюю оценку, бенчмарк допускал два соседних правильных ответа (например, «Ложь» и «Неопределено»).
Кроме того, чтобы материал подходил под формат Factbutcher, из каждой статьи выделялось одно короткое проверяемое утверждение. Из статей, где разбирается несколько независимых утверждений — например, про пять несуществующих цитат из книг или подборку фейков о миграционном кризисе — мы брали каждое как отдельный кейс. Случаи, которые нельзя проверить по тексту — где нужно смотреть фотографию, видео или таблицу, — в набор не попали.
Материалы «Проверено.Медиа» использованы по лицензии Creative Commons CC BY 4.0.
Как распределились вердикты
Зачем нужны несколько допустимых вердиктов
Иногда вердикт нельзя определить однозначно — не потому что данных мало, а потому что утверждение честно допускает два прочтения. В этом случае бенчмарк засчитывает соседние ответы: например, и «правда», и «неопределено». Расширенный набор допустимых ответов был у 120 из 423 утверждений (28%), в основном в пользовательской части набора.
Например, «Не все орехи являются плодами». В строгой ботанической терминологии настоящий орех — это плод, но в обычной речи к орехам относят также семена и бобовые. Поэтому в обычном смысле утверждение верно, но и «Неопределено» тоже допустим из-за неуточненного значения слова.
Важно, что допустимыми могут быть только соседние позиции: «правда» и «не определено» либо «ложь» и «не определено». Пара «правда» и «ложь» невозможна.
При отборе утверждений мы немного сместили пропорцию в сторону вердиктов «Правда» и уменьшили долю «Неопределено». Это связано с тем, что модели и так легче склоняться в сложных случаях в «Неопределено». А правду часто сложнее доказать, чем ложь. В таблице показаны итоговые вердикты после проверки и редактирования:
| Компонент | Правда | Ложь | Неопределено | Всего |
|---|---|---|---|---|
| Пользовательские утверждения | 141 | 80 | 53 | 274 |
| «Проверено.Медиа» (Provereno.Media) | 48 | 72 | 29 | 149 |
| Всего | 189 | 152 | 82 | 423 |
Какие модели и конфигурации мы тестировали
Основной пул строился вокруг трех практических условий:
- У модели есть встроенный веб-поиск или поисковый режим.
- Ожидаемая цена подходила массовому продукту: целевой уровень — не более $0,05 за проверку, жесткий предел — $0,10.
- Модель относилась к актуальной линейке одного из ведущих поставщиков. В наш пул попали OpenAI, Anthropic, Google или Perplexity.
Отдельно мы проверили несколько дорогих сильных моделей, чтобы понять возможный потолок качества.
Мы проверяли семейства GPT-5.4 и GPT-5.6 Luna, Claude Haiku и Sonnet, Gemini Flash и Pro, а также Perplexity Sonar. Мы сравнивали конфигурации — модель вместе с ее настройками. У всех разные настройки.
- OpenAI позволяет менять глубину рассуждения и объем поискового контекста.
- У Anthropic можно ограничить число поисков.
- У Gemini глубина рассуждения влияет на то, решит ли модель вообще обратиться к поиску.
Поэтому одна и та же модель с разными параметрами могла заметно отличаться по цене, скорости и поведению.
Как проходил отбор
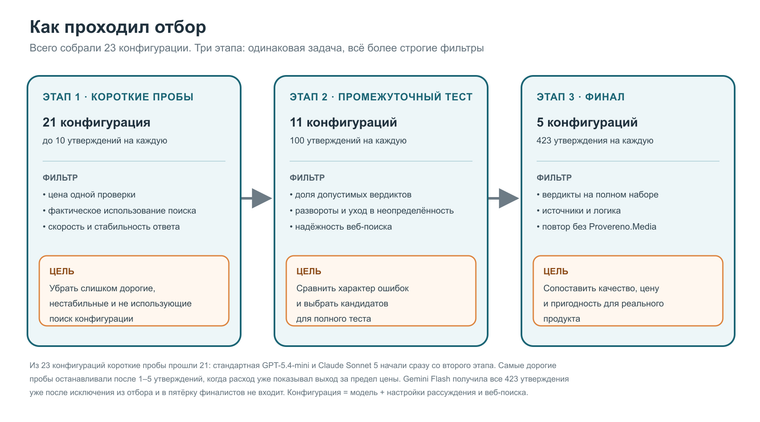
Проверять все конфигурации сразу на 423 утверждениях было бы слишком дорого, так что мы разделили работу на три этапа.
Как мы исключили готовые ответы «Проверено.Медиа»
В первом полном прогоне модели часто находили сайт «Проверено.Медиа» и брали вердикт из той же статьи, на которой был основан эталон. Поэтому мы заблокировали этот домен в поиске и повторили все затронутые задания.
Впрочем, результаты сильно не поменялись: лидеры рейтинга остались те же.
Какие конфигурации мы отсекли
- Совсем дорогие. Многие варианты остановили уже на первом этапе, потому что цена оказывалась слишком высокой. Так осеклись модели Sonnet-5, GPT-5.4 и GPT-5.5, конфигурации GPT-5.4-mini со средним уровнем рассуждения.
- Совсем слабые. Так, базовая Sonar и Sonar Pro (обе от Perplexity) оказались значимо слабее других вариантов на 100 заданиях.
- Те, у которых более дешевые версии лучше. Часто более простые конфигурации одной и той же модели давали такой же или даже более качественный результат как более продвинутые и дорогие. Например, Claude Haiku 4.5 с более широким поиском стоила в 1,5 раза дороже, но на промежуточном тесте дала результаты даже ниже чем ее более дешевый и ограниченный вариант.
- Обманщики. Gemini Flash и Gemini Pro заняли первые места по доле верных вердиктов на промежуточном тесте, но при этом не искали реальные источники, а иногда и выдумывали их.
Базой у Factbutcher была модель GPT-5.4-mini с поиском, но без рассуждений. Мы ее оставили на финальную стадию, чтобы сравнить с остальными и откорректировать работу Factbutcher.
Что показали финальные тесты
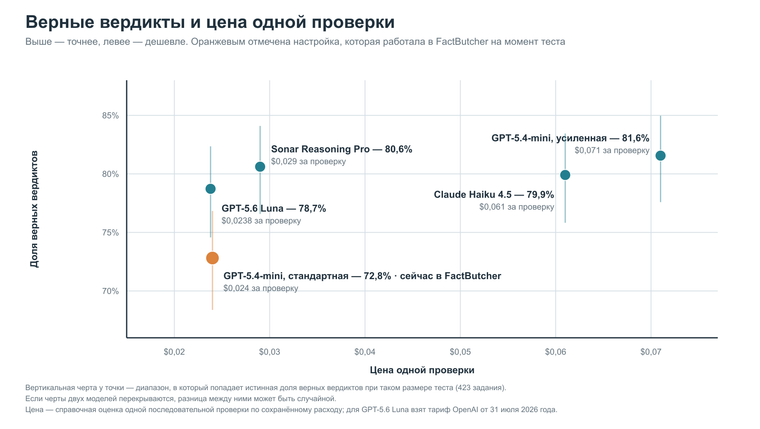
Дя финальной стадии были отобраны 5 конфигурации:
- стандартная GPT-5.4-mini, которая использовалась на тот момент в FactButcher
- усиленная GPT-5.4-mini (с режимом рассуждений)
- Sonar Reasoning Pro
- Claude Haiku 4.5
- GPT-5.6 Luna
Все их мы прогнали через полный набор из 423 утверждений. Все четыре новые конфигурации показали близкие значения (около 80% правильных ответов) и значимо опережали текущую (73%), но при этом были в основном дороже.
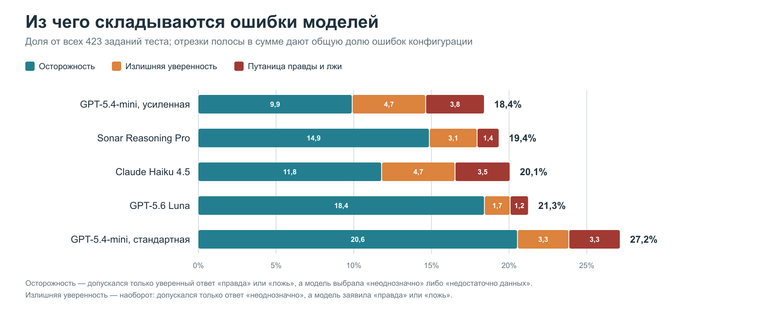
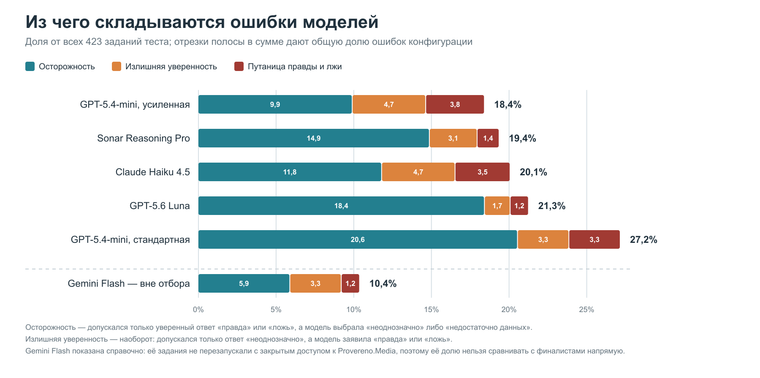
20% — вроде бы высокая доля ошибок? Не совсем. Абсолютное большинство того, что мы пометили как «ошибки» — результат осторожничанья моделей: они писали «неопределено» вместо «правды» или «лжи», но при этом не приходили к выводам противоположным реальным.
Вообще модели гораздо чаще склонны к выбору безопасного варианта, особенно если утверждение можно интерпретировать по-разному.
Например, утверждение «дофаминовое голодание полезно» ложно (в «Проверено.Медиа» его обозначили как «заблуждение»). Все модели выбрали вариант «неопределено». У Claude Haiku 4.5 «утверждение о пользе дофаминового голодания не подтверждается научными данными», а концепция «построена на неправильном понимании механизма действия дофамина», — но модель равно выбрала промежуточный вердикт, потому что отказ от соцсетей и видеоигр может косвенно улучшить концентрацию.
Еще пример — утверждение «Вирусные фото показывают, как Брендан Фрейзер тренируется для съёмок фильма „Мумия 4“» ложно (разбор от 17 мая 2026 года). Однако некоторые модели все равно поставили «Неопределено» обосновав тем, что «Фрейзер действительно готовится к роли».
В общем 20% не должны вас пугать, никаких критических ошибок. А порой такое поведение моделей может даже полезно, чтобы читатель сам сделал финальный выбор, дав фактологическую аргументацию.
Доля случаев грубых ошибок, когда модель меняла вердикт на противоположный («правда» вместо «лжи» и наоборот), небольшая — 1,2–3,8% от всех ответов, зависит от модели.
Как модели объясняют вердикты
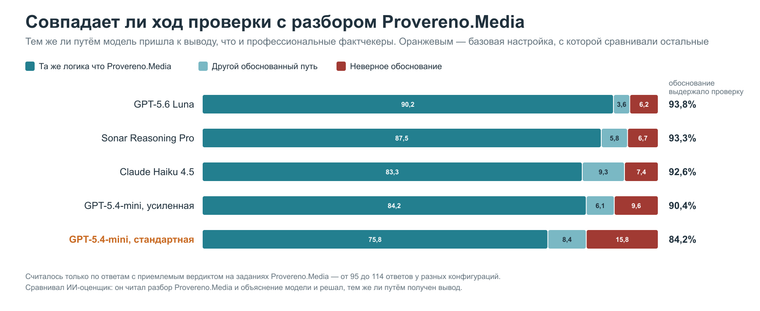
Для финалистов мы не только прогнали каждую через полный набор утверждений, но и проверили, как они обосновывали свой вердикт:
- Действительно ли из обоснования модели следует вердикт. То есть если принять факты и аргументы, которые сама модель изложила в обосновании, следует ли из них тот вердикт, который она поставила?
Так, у mini_default примерно 20% ответов содержит заметный разрыв между тем, что модель сама рассказала, и тем вердиктом, который она затем выбрала. Solar и Luna оказались значимо лучше остальных моделей, у них доля таких ответов — менее 8%.
- Сравнение логики обоснования с «Проверено.Медиа». Совпадает ли логика модели с опубликованным профессиональным разбором? Или же логика была неверной, и модель просто угадала?
Здесь в большинстве случаев все модели следовали той же логике, что «Проверено». Так как выборка здесь была небольшая, то значимых отличий не было обнаружено, кроме mini_default, которая оказалась слабее лидеров.
Что с Gemini?
В дополнение к 5 основным моделям мы также протестировали Gemini.
Gemini-flash дала больше всего правильных ответов на предварительном тесте. Однако она практически никогда не пользовалась веб-поиском (менее 10% случаев). При этом от модели мы ожидаем следующее:
- модель сама составляет и делает поисковый запрос в поисковик,
- использует полученные результаты,
- возможно, делает дополнительные поисковые запросы,
- и на основе всей полученной информации делает финальный вывод.
В Gemini же инструмент веб-поиска настроен так, что модель в каждом случае сама решает, искать или нет. Причем эту настройку не поменять. И в большинстве случаев в нашем исследовании Gemini считала, что справится сама, даже после того, как мы добавили в промпт отдельное указание использовать веб-поиск,
Все современные большие языковые модели обучаются на огромном массиве данных — книгах, статьях, блогах, новостях и тд. Поэтому существенную часть часть информации, которую пользователи обычно запрашивают, они действительно “знают”.
А Gemini не делала веб-поиск и, соответственно, не могла дать ссылки на источники. Но наш запрос требовал ссылки на источники, так что Gemini их просто выдумывала.
Для Factbutcher такая модель неприемлема, но ради интереса мы прогнали её через весь датасет, так сказать, вне конкурса.
Gemini в 2-3 раз реже осторожничала (выбирала «Неопределено»), чем другие модели. По другим ошибкам она значимо не отличалась от лидеров.
Что в итоге?
- ИИ надежен для фактчекинга. Грубые ошибки редки (1–3%), чаще модель просто осторожничает. При этом обоснования вердиктов чаще схожи с такими же у профессиональных фактчекеров.
- Успешные модели не всегда самые дорогие. Например, у Anthropic (Haiku) или некоторых GPT от OpenAI, более эффективными могли оказаться более дешевые варианты.
Попробовать FactButcher можно на сайте factbutcher.com, в телеграм-боте (можно вбить текст или просто переслать пост боту для проверки) и через расширение для Chrome (выделяете текст на странице и одной кнопкой просите FactButcher проверить его).
Что мы будем делать дальше?
Мы продолжим работать над изучением способов улучшить фактчекинг, а именно планируем:
- Расширить количество утверждений в нашем наборе;
- Протестировать промпты (в том числе, чтобы снизить фактор осторожничания моделей);
- Улучшить этапа выделения утверждений из запросов пользователей.
Материалы «Проверено.Медиа» использованы по лицензии Creative Commons CC BY 4.0.